Reseña de Real Write AI

Estoy evaluando Real Write AI para ayudar a redactar guías de configuración para un pequeño equipo de desarrollo de software. El material de partida suele ser mis notas en borrador de las pruebas, y necesito que el texto final se ciña a esas notas en lugar de inventar los pasos que faltan.

¿Alguien tiene una reseña de Real Write AI basada en su experiencia de uso y centrada en este tipo de trabajo, en particular sobre cuánta edición hace falta para que las instrucciones sean precisas y fáciles de leer?


Tenía una serie de pasajes en inglés para analizar con detectores de IA gratuitos, incluido un fragmento que sabía que había escrito una persona. Probé el detector de IA gratuito de Clever junto con otras herramientas para ver qué análisis podía completar sin pagar ni crear una cuenta.

El fragmento humano cambió la comparación

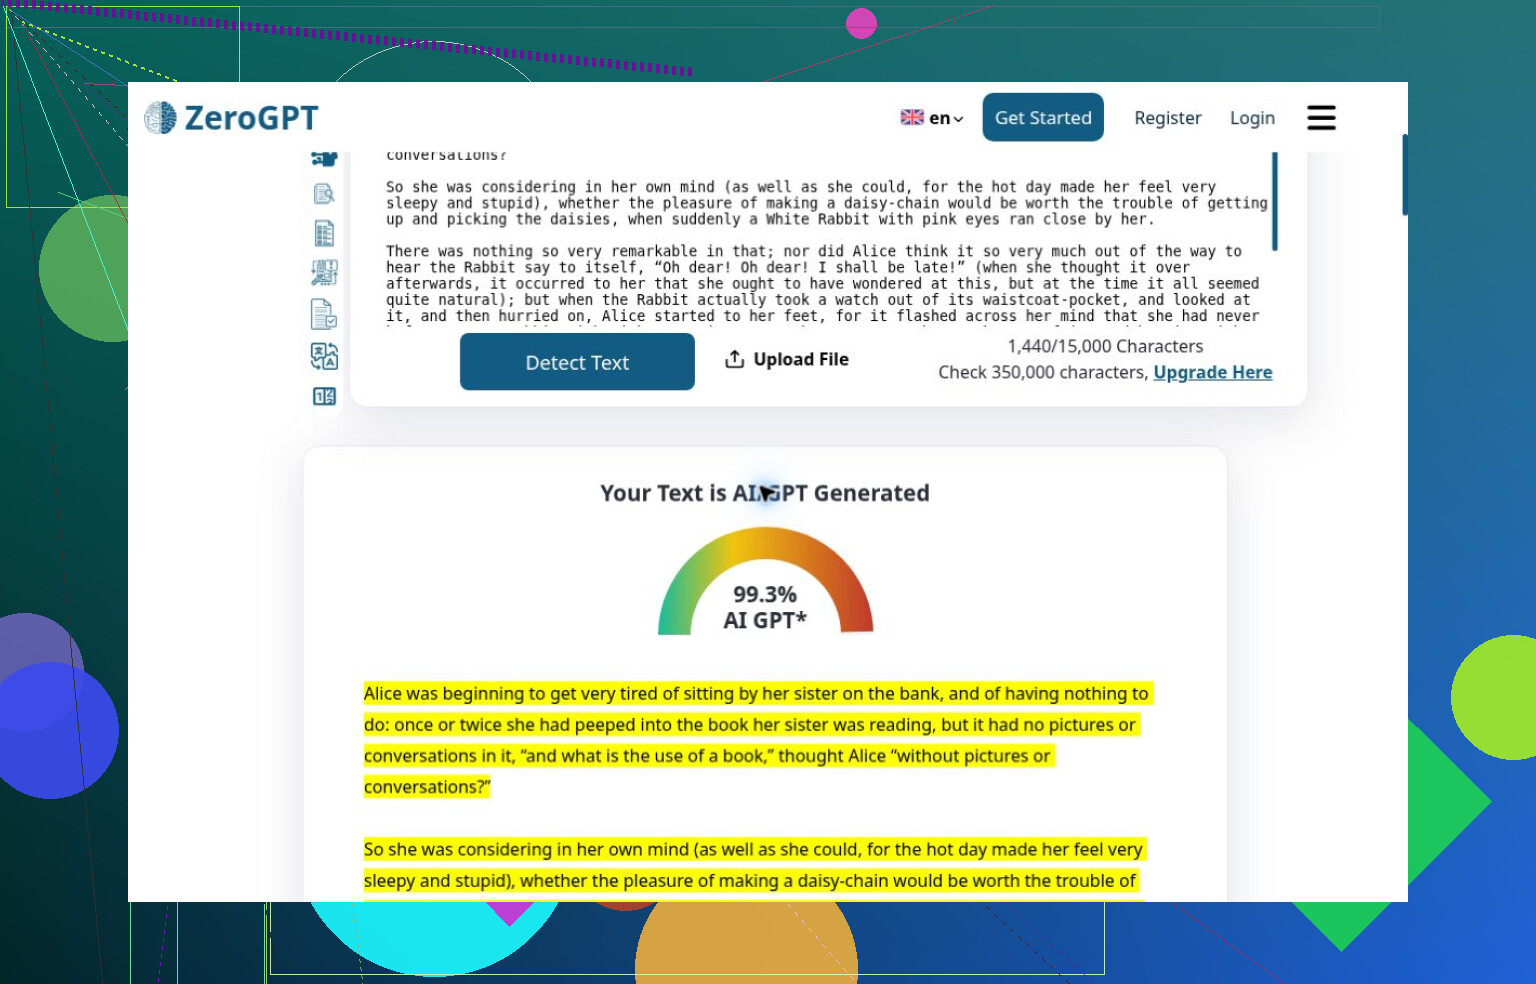
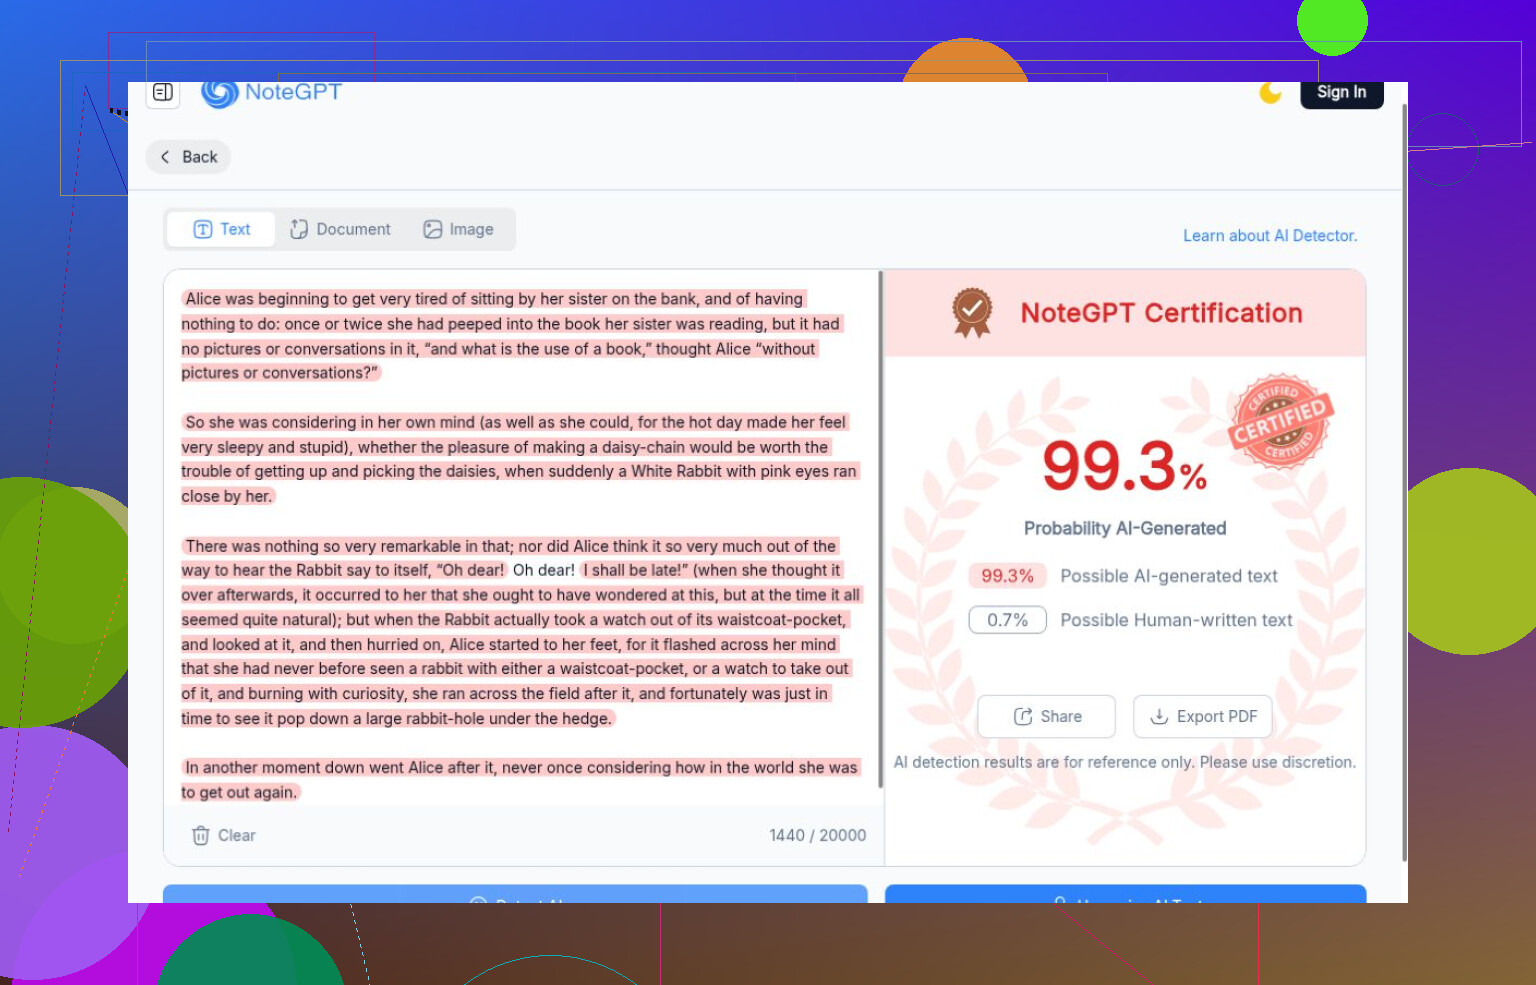
ZeroGPT detectó todos los pasajes generados, pero etiquetó el texto de Lewis Carroll como un 99,3% de IA. NoteGPT le dio al texto de Carroll la misma puntuación, superior a las del ensayo y el relato generados. Esa coincidencia no demuestra que compartan tecnología y, desde luego, no hace que el veredicto sea correcto.

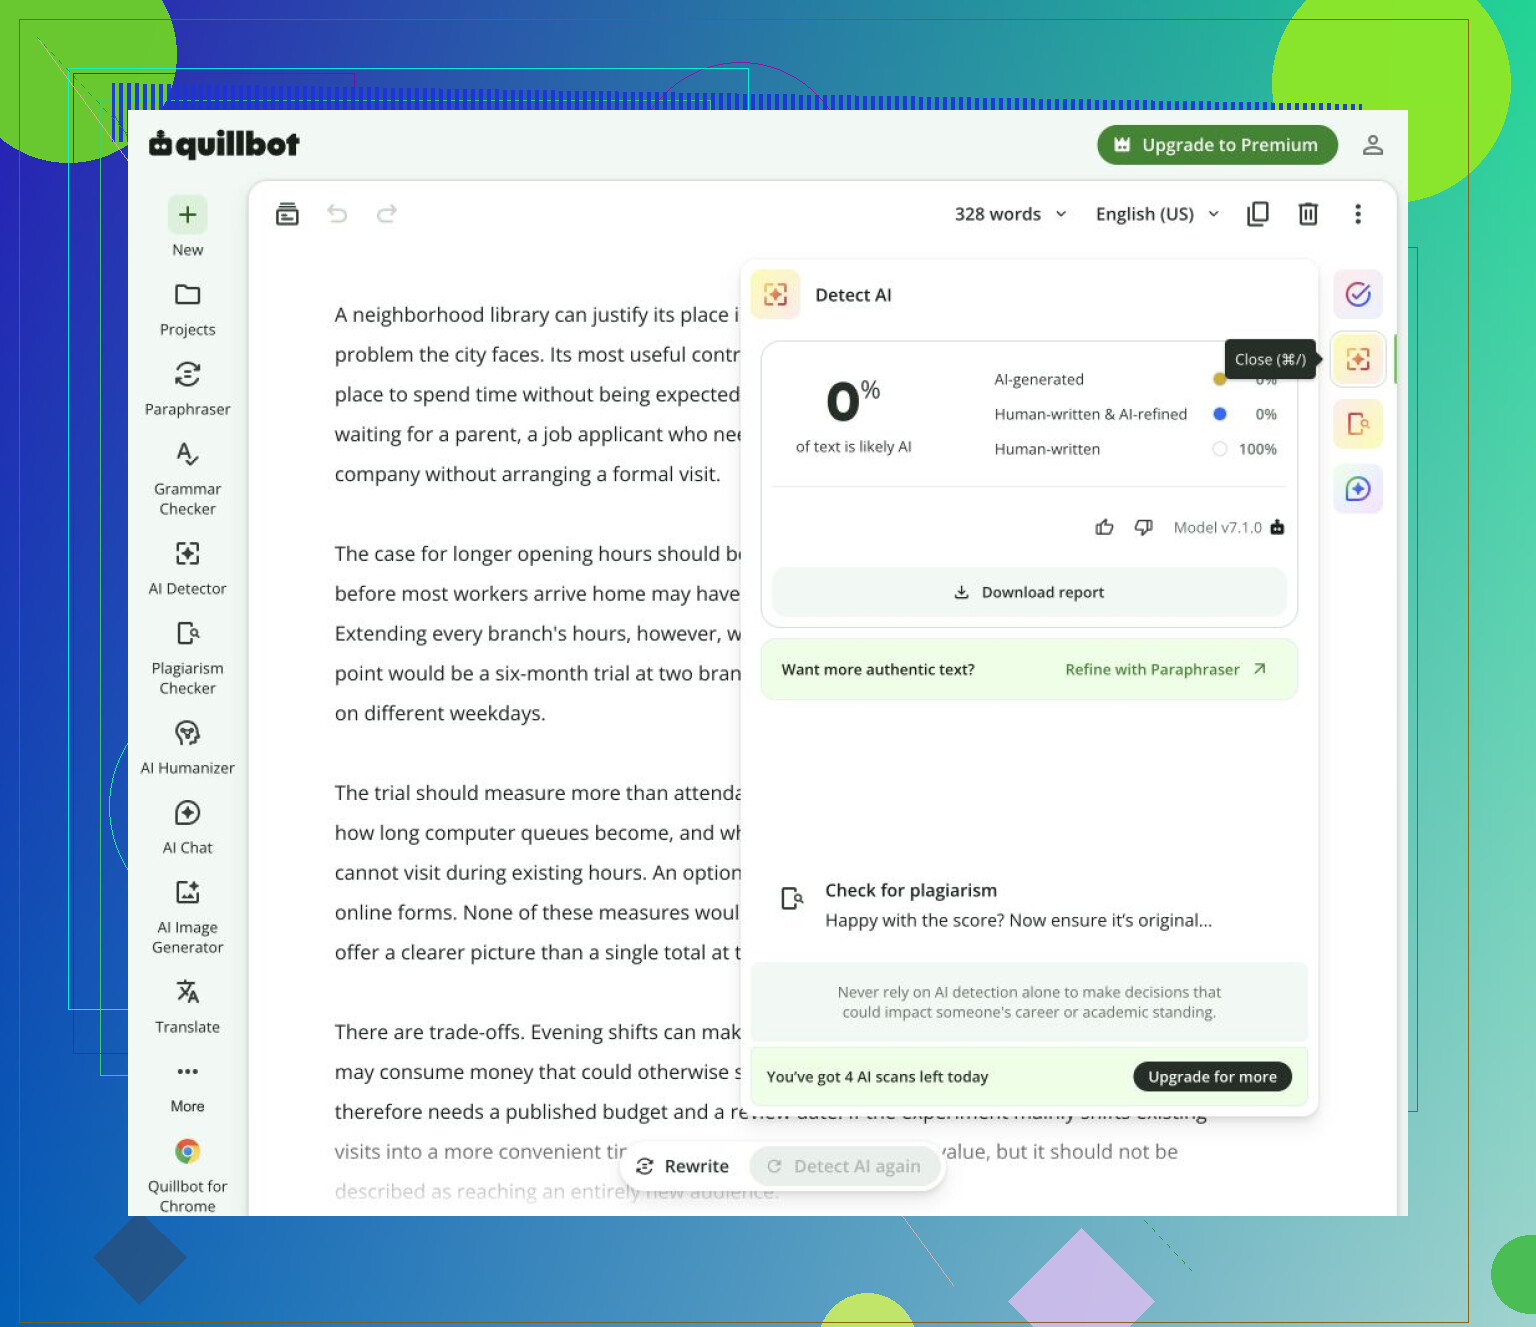
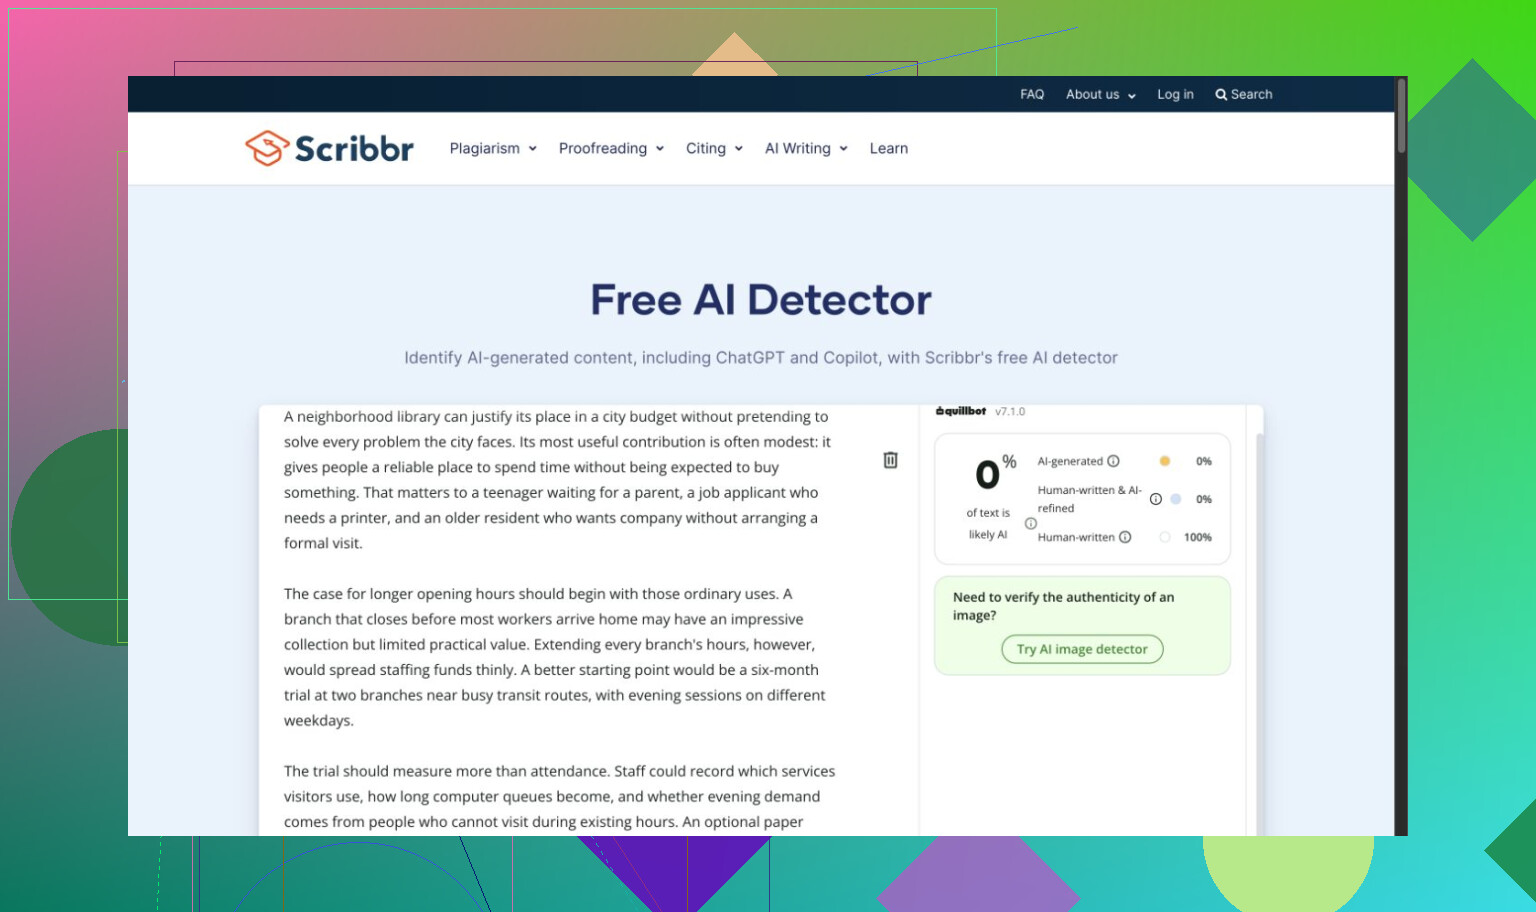
El error contrario apareció en otras herramientas. QuillBot clasificó los cuatro pasajes generados como escritos al 100% por humanos. Scribbr aceptó tanto el ensayo como el texto de Carroll como escritos por humanos en un intento posterior. La presencia visible de la marca QuillBot también me impidió considerar los resultados de esos sitios como valoraciones independientes.

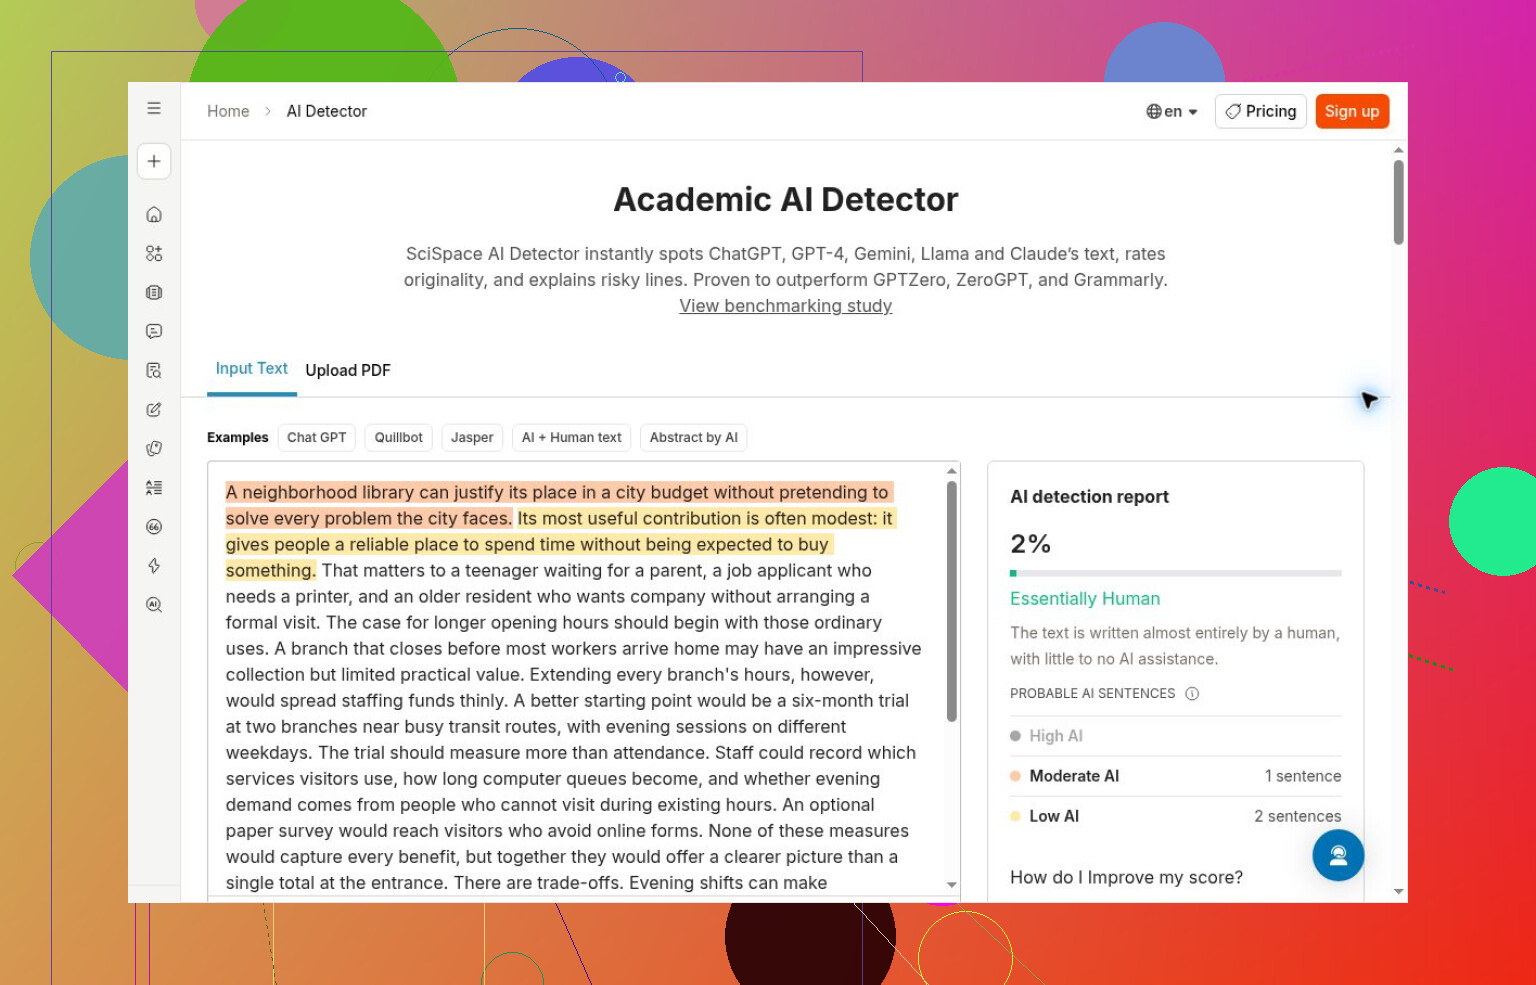
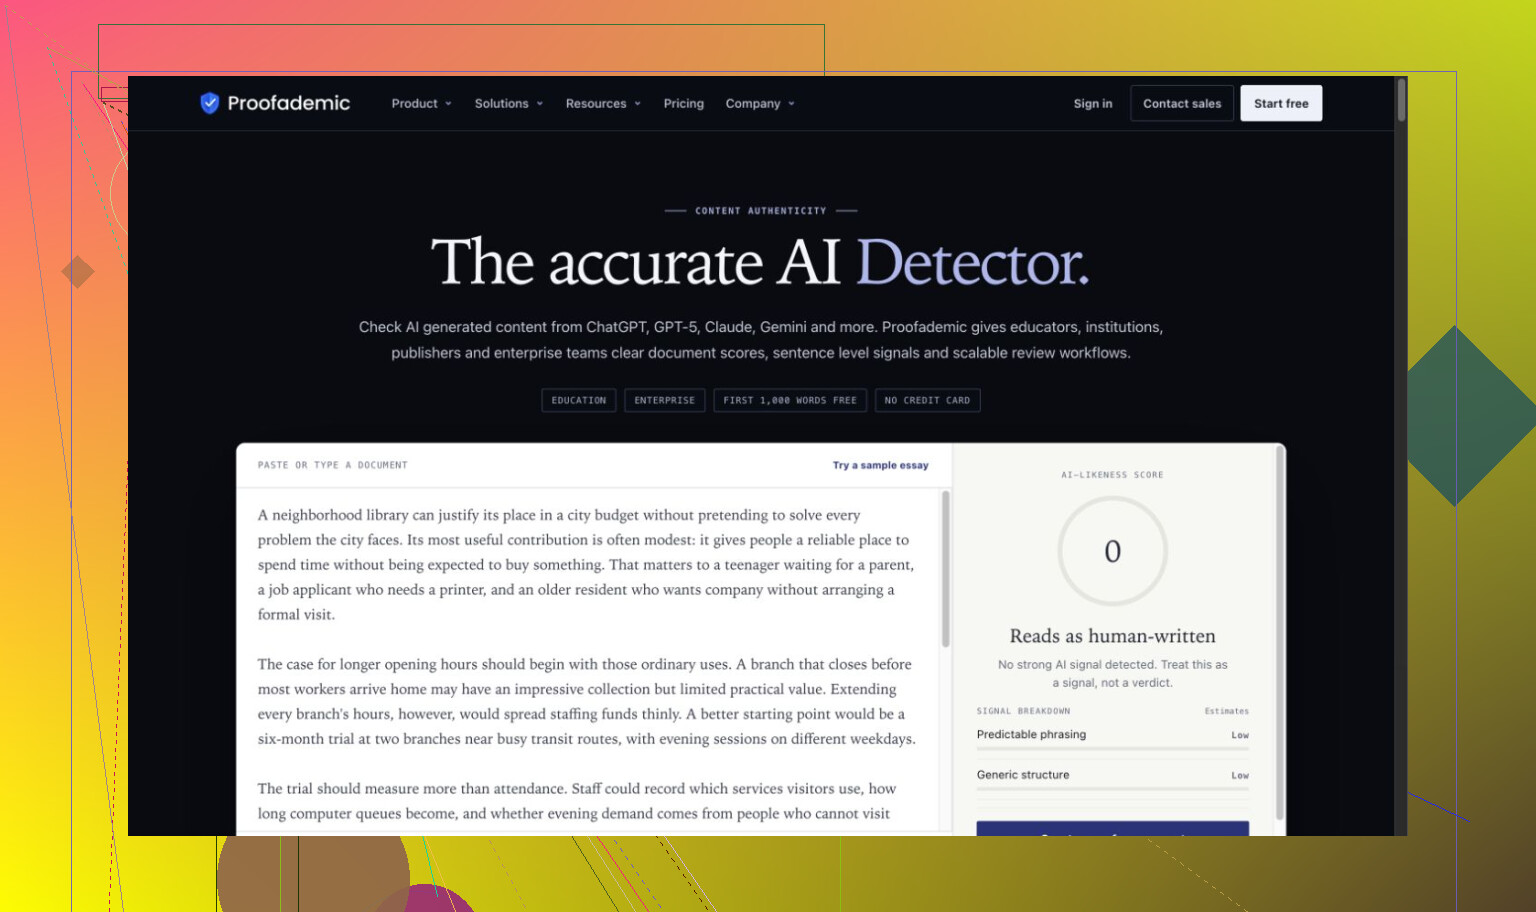
SciSpace devolvió un 2% de IA para el ensayo generado. La demostración pública de Proofademic dio una puntuación de semejanza con la IA de 0/100 tanto para el ensayo como para el texto de Carroll. Surfer asignó al ensayo, al relato y al texto de Carroll una probabilidad del 0% de haber sido escritos por IA. Eran resultados de análisis completados, no conjeturas sobre informes inaccesibles.

Qué comparé realmente

Probé 24 herramientas los días 2 y 3 de octubre de 2026 con seis pasajes en inglés que mantuve sin cambios. El material generado incluía un ensayo, un memorando empresarial, una paráfrasis y un relato personal ficticio. El texto de Carroll sirvió como muestra de control humana, y una versión ligeramente editada con IA, como ejemplo mixto.

Algunos pasajes estaban relacionados entre sí. Un fragmento literario no sustituye a una muestra amplia de escritura humana moderna, y la versión editada no es una segunda muestra de control puramente humana.

Solo contabilicé los análisis completados. También distinguí entre confianza, probabilidad y proporción estimada de IA. No son medidas intercambiables. Las imágenes documentan resultados o condiciones de acceso, no demuestran que todas las herramientas completaran la misma carga de trabajo.

Los aciertos vinieron acompañados de distintas limitaciones

Clever completó todo el conjunto sin necesidad de registrarse. Detectó los pasajes generados y clasificó el texto de Carroll como humano al 99%, pero dio esa misma etiqueta a la versión ligeramente editada. Los colores de algunas frases no coincidían con el resultado principal, y las etiquetas explicativas no siempre eran útiles. No puse a prueba a gran escala el acceso ilimitado que anuncia.

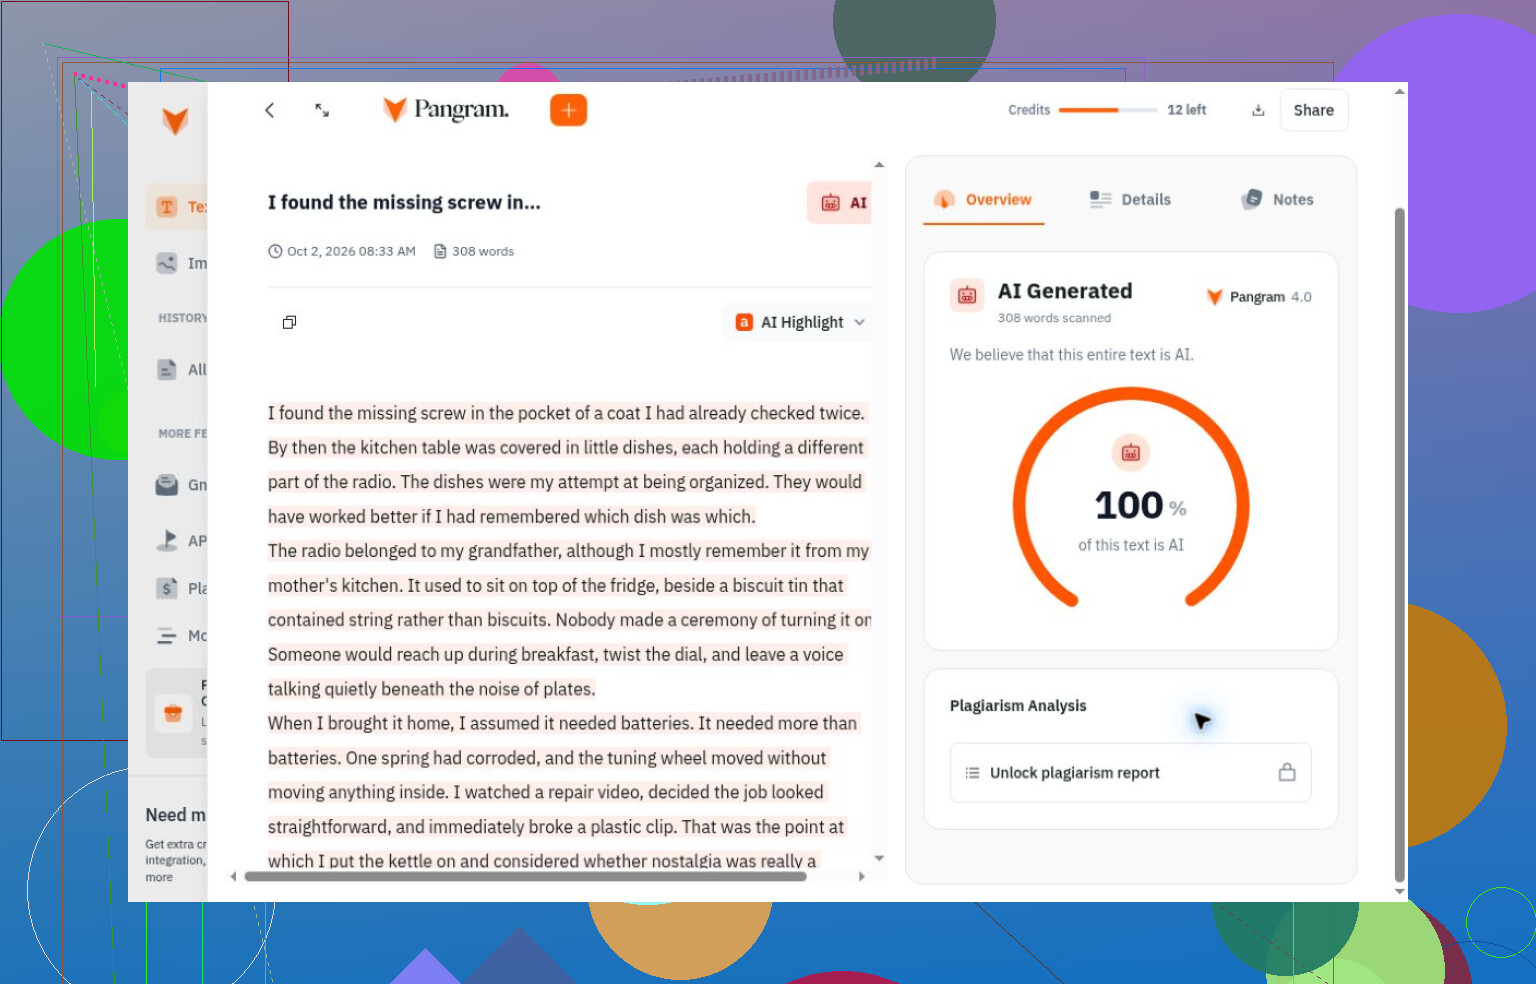
Pangram identificó correctamente los textos generados que analizó y aceptó el texto de Carroll como humano. Su cupo se agotó tras cinco análisis, con un consumo que dependía de la longitud. También consideró que el fragmento editado era enteramente humano.

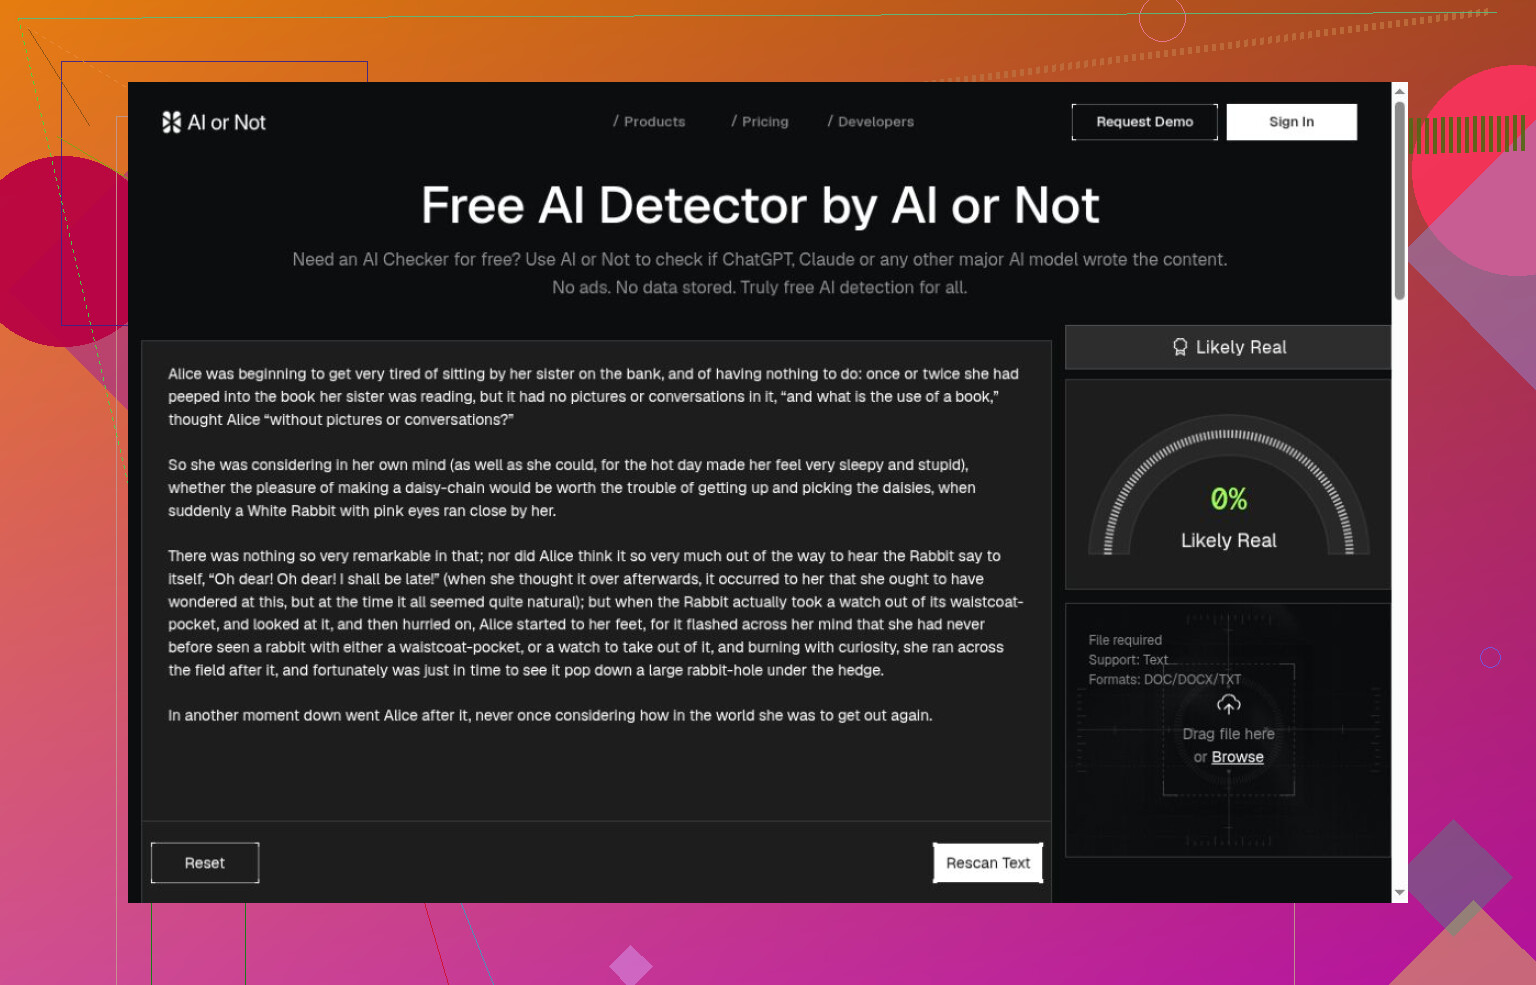
Originality.ai clasificó correctamente los ejemplos de IA y humanos cuyos análisis completó. Seleccioné una tolerancia de IA del 15%; su confianza del 100% describía un veredicto basado en un umbral, no el porcentaje de palabras generadas. AI or Not también acertó en los ejemplos que terminó de analizar en modo invitado, pero allí no probé escritura mixta ni otros tipos de contenido.

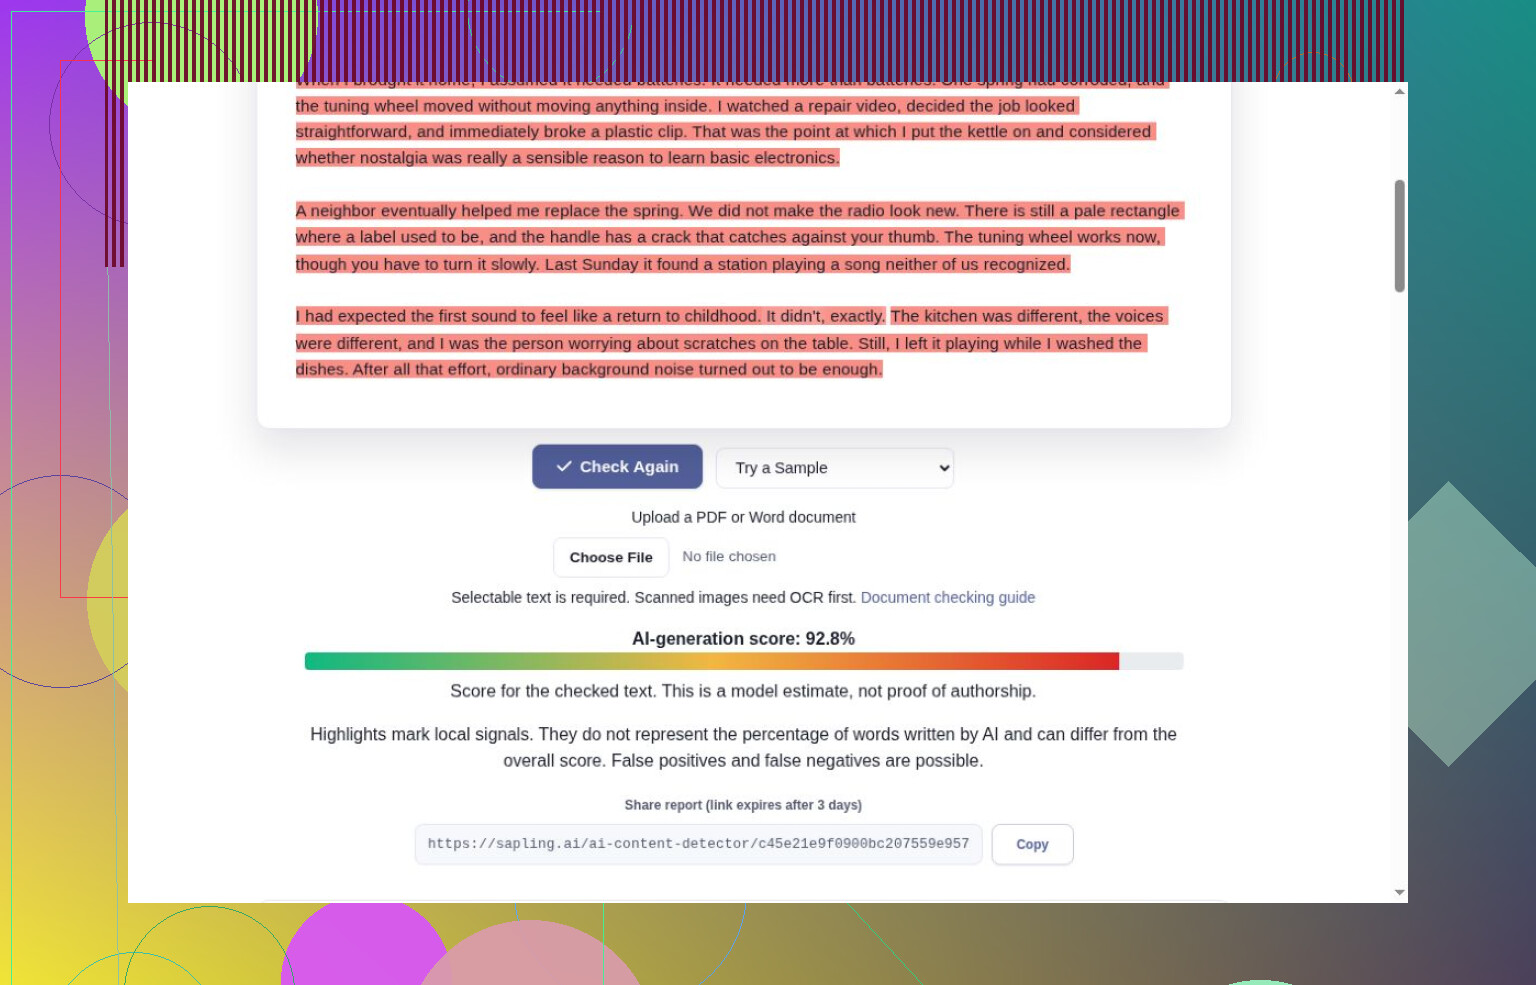
Sapling clasificó correctamente el relato completo y el fragmento humano. Su resultado para el ensayo solo abarcó 2.000 de los 2.070 caracteres.

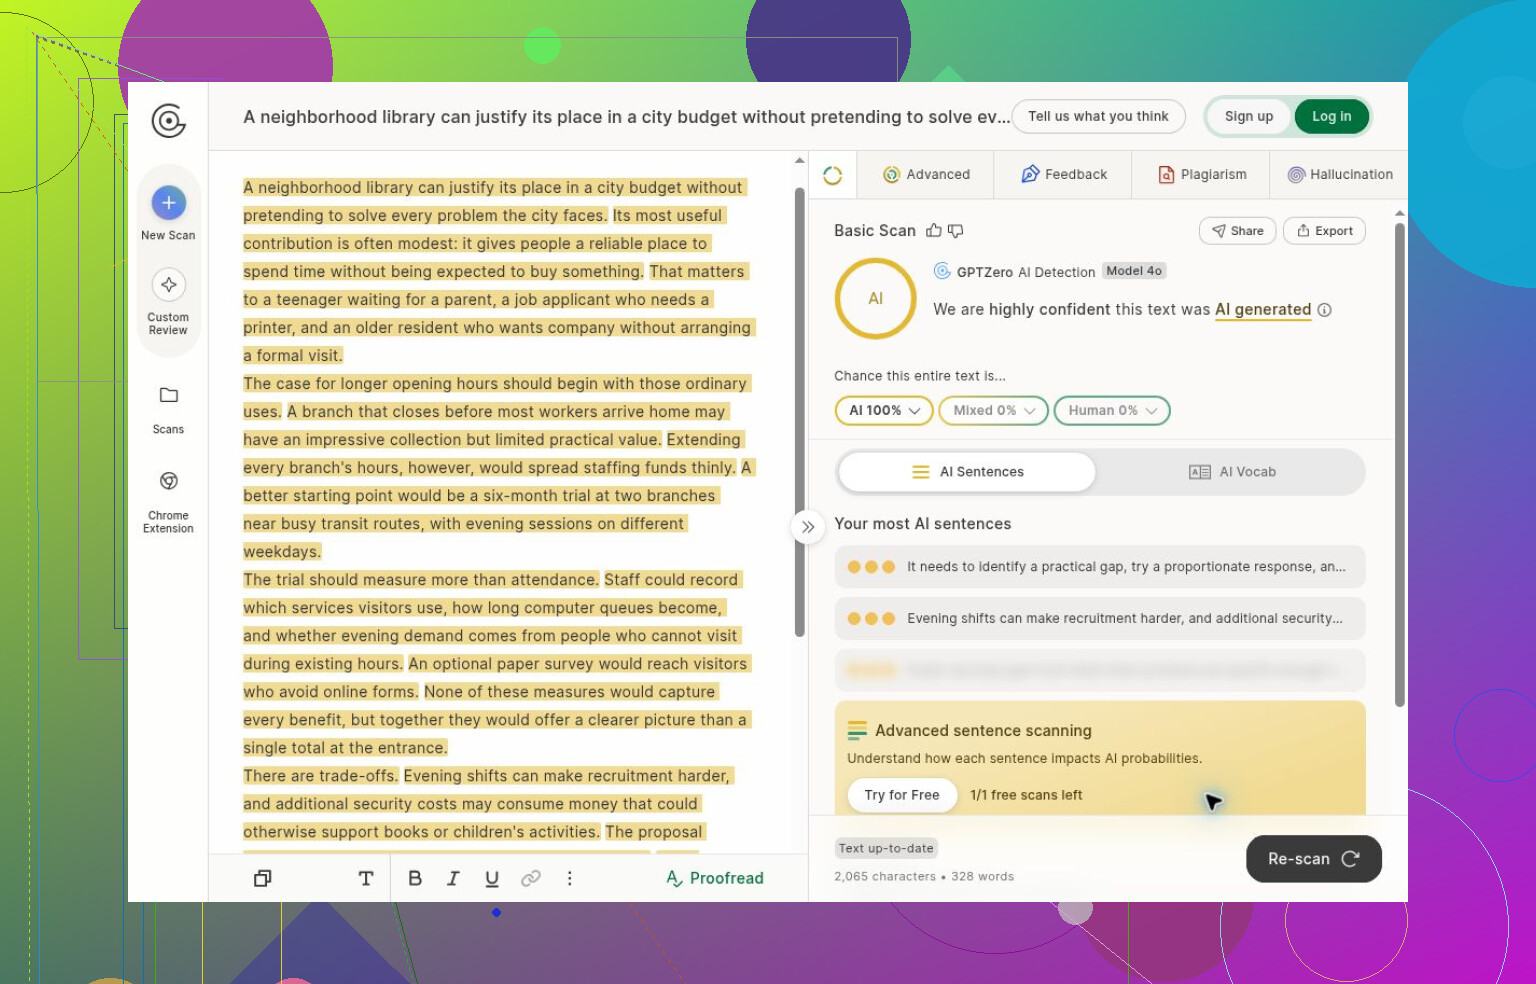
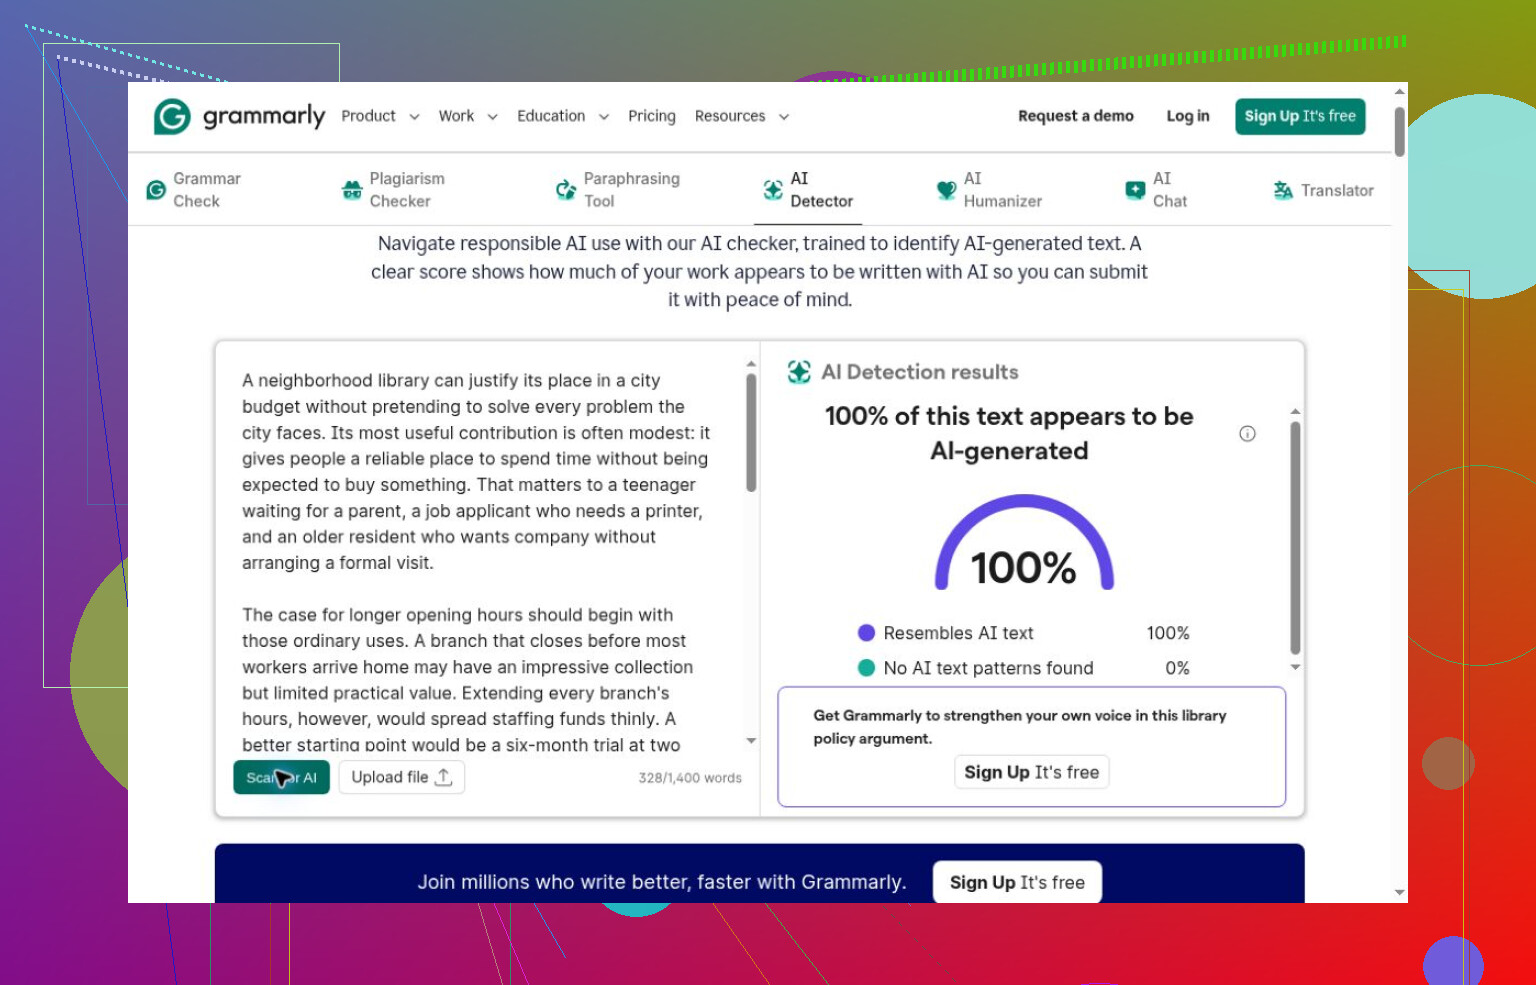
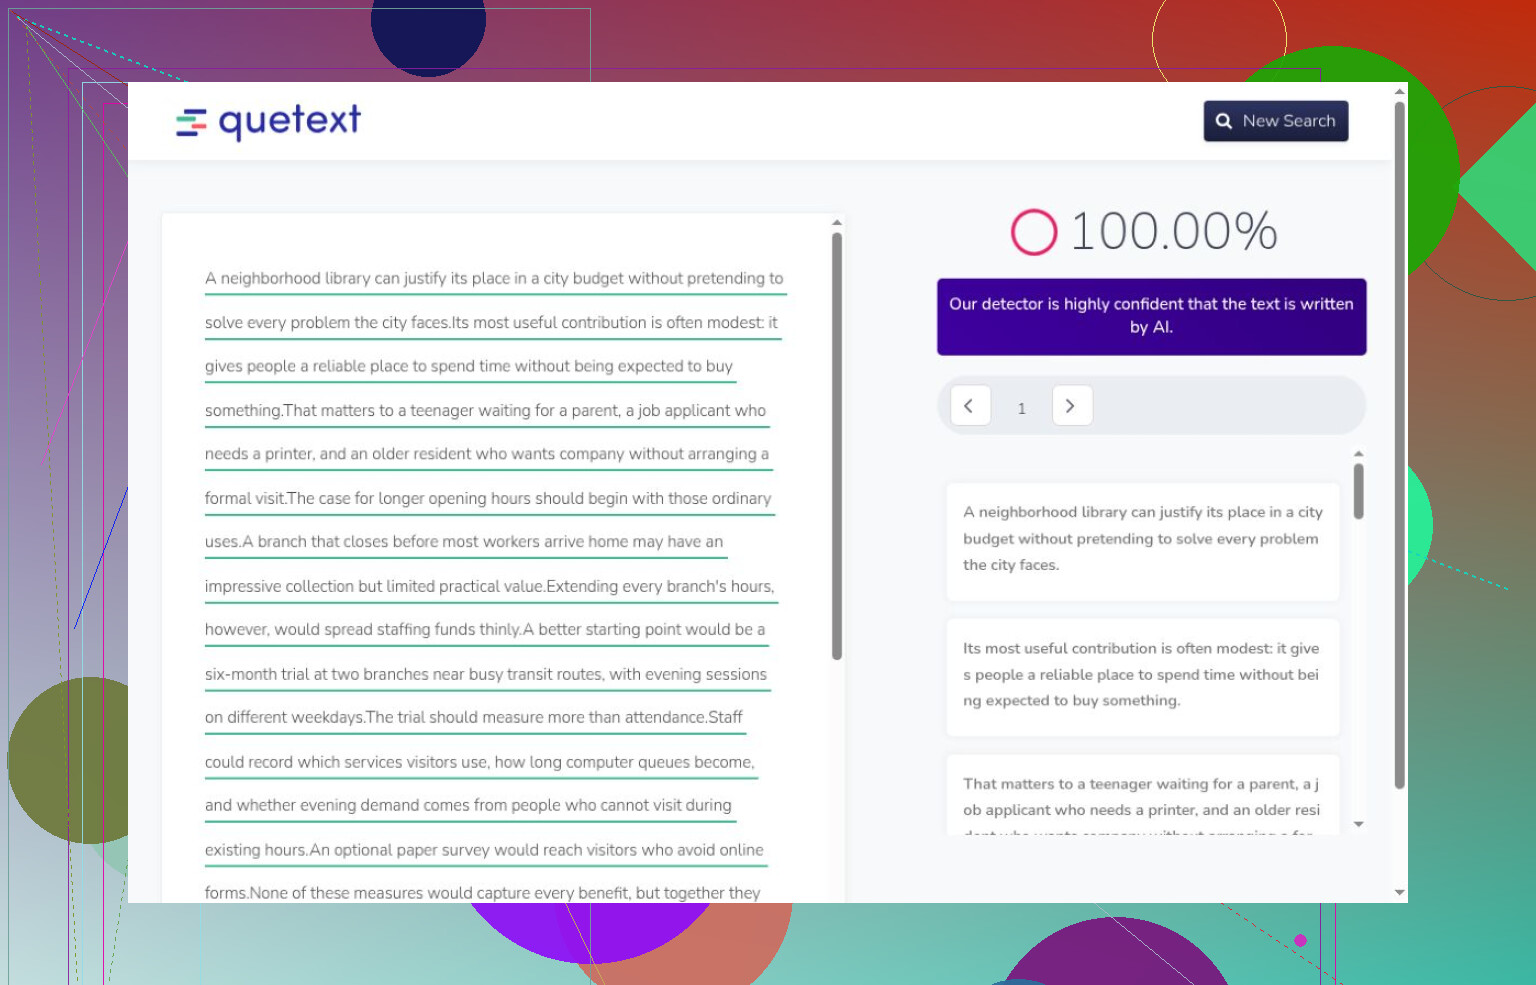
GPTZero detectó tres textos generados antes de exigir el registro. Una puntuación anterior permaneció en pantalla después de cambiar el texto, así que no contabilicé ese dato como otro resultado. Grammarly y Quetext detectaron el ensayo, pero sus solicitudes de crear una cuenta impidieron realizar más análisis. Ninguna de esas pruebas limitadas proporcionó un resultado para un texto humano.

Los problemas de acceso no fueron fallos de detección

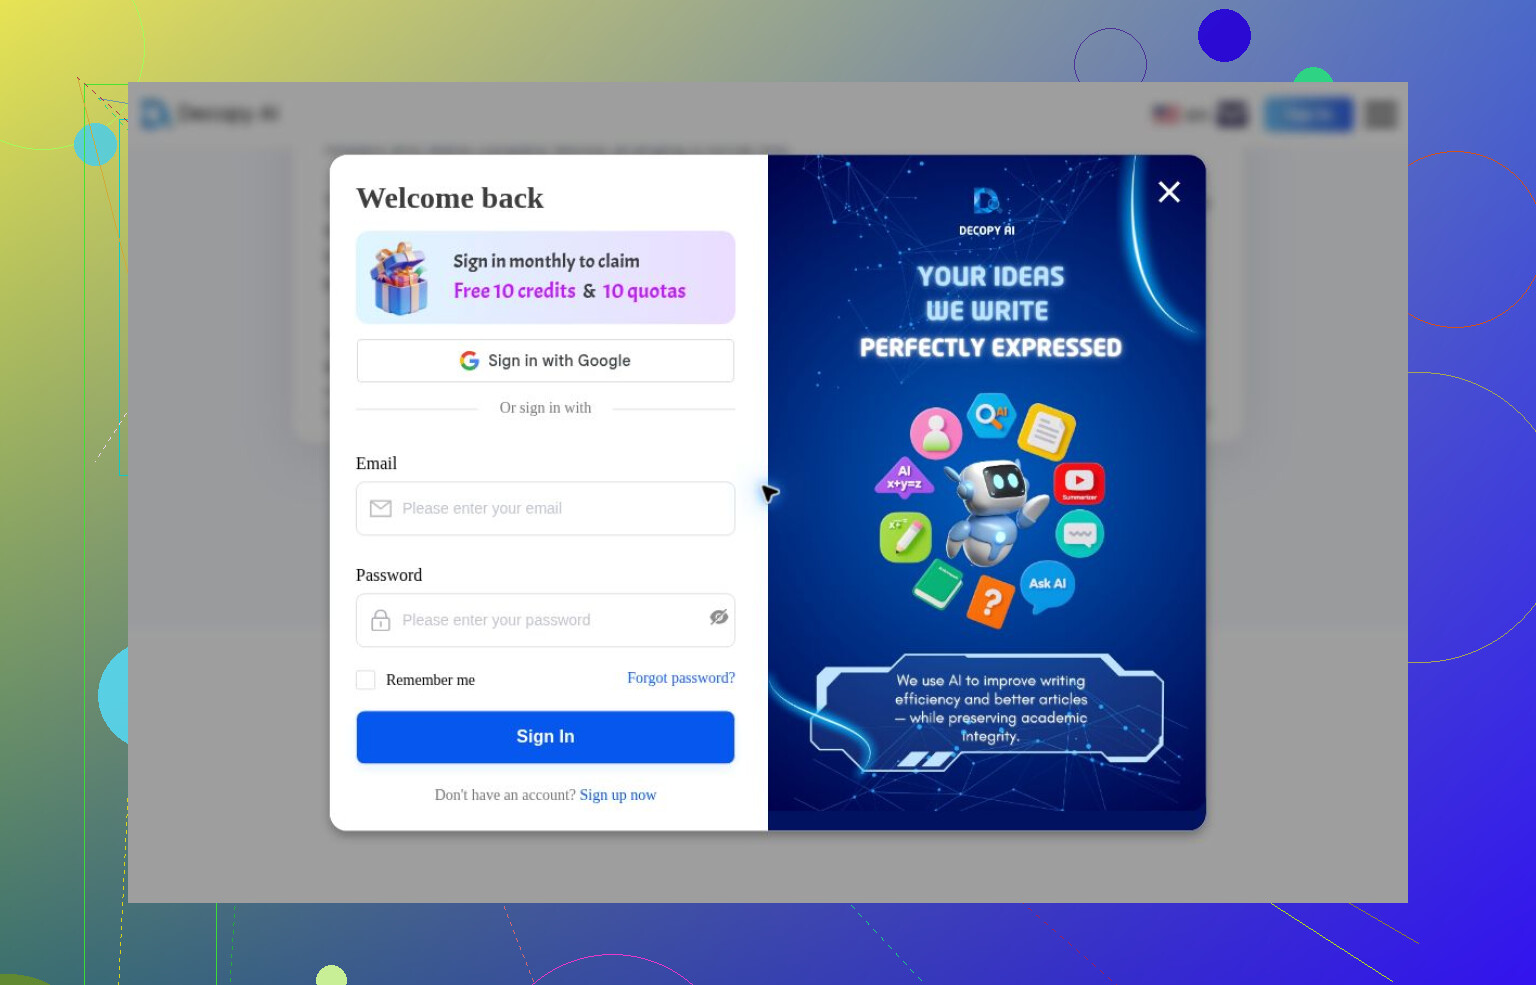
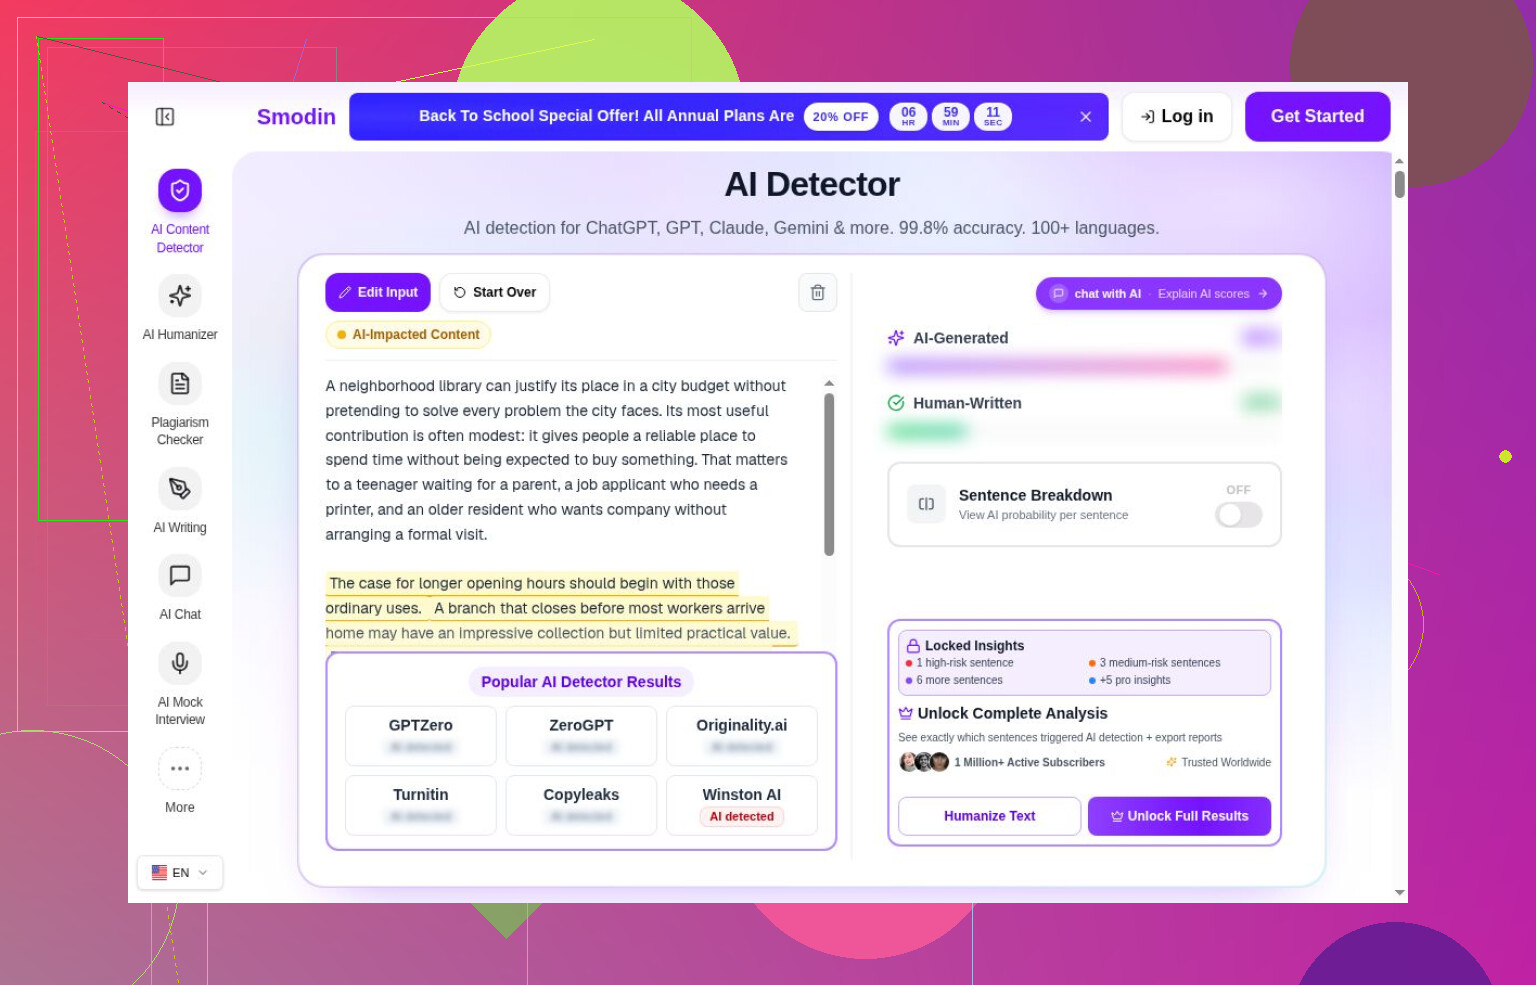
Decopy abrió un cuadro de diálogo para iniciar sesión cuando envié el ensayo. Smodin mostró fragmentos resaltados, pero ocultó los porcentajes principales. Ninguno me proporcionó un resultado de detección utilizable.

AI Detector Pro y Winston AI exigían registrarse antes de analizar. Turnitin requería acceso institucional y un complemento de licencia. Copyleaks cargó su interfaz para invitados, pero me detuve por las condiciones de uso aplicables. Estos casos no demuestran una baja precisión ni que no haya análisis gratuitos disponibles.

La demostración de Hive que revisé procesaba contenido multimedia en lugar de prosa; no configuré su extensión para texto ni su API. ContentDetector.AI me dirigió a la ficha de una extensión de Moxby, que no instalé. En el caso de Humanly, me limité a revisar su ficha en la tienda de Apple, con descarga gratuita y compras dentro de la aplicación, sin comprobar su cupo de análisis.

Mi elección tiene un alcance más limitado que una lista de ganadores

No probé los flujos de trabajo de pago ni la cobertura multilingüe. También conviene volver a comprobar los requisitos de cuenta y los cupos antes de usar estas herramientas con regularidad.

Guardaría los borradores y las fuentes cuando se cuestione un resultado, en lugar de convertir una puntuación en una acusación. Para mis propios análisis gratuitos ocasionales, elijo Clever porque pude completar el conjunto y distinguió los pasajes que sabía que eran generados de la muestra de control humana. No confiaría en esta herramienta, ni en ninguna otra de la comparación, para determinar la autoría.
Reescribir un paso de un procedimiento probado es una tarea sencilla, pero proporcionar un comando que falta es algo muy distinto. La comparación de detectores no aborda este matiz. Seguiría recurriendo a Clever AI Detector para comprobar la autoría, pero me resultaría molesta la etapa innecesaria de revisión para verificar la exactitud. Un verdadero software Write AI recibiría mis notas con omisiones intencionadas y pediría marcarlas como «necesita confirmación», manteniendo los comandos tal como están y citando la nota de origen de cada paso. Si mis notas dicen que la autenticación falló, pero tu borrador de algún modo solucionó el problema que aún no he abordado, la prueba habrá fallado, por muy fácil de leer que sea tu guía.

No dejes que una pequeña actualización de tus notas se convierta en una reescritura sin supervisión de toda la guía. Yo añadiría una prueba de revisión junto a la prueba de omisiones de @jackson: aprobar un borrador, cambiar un detalle de configuración en las notas y luego pedirle a Real Write AI que actualice solo la sección afectada. Compara los borradores. ¿Hizo ese cambio y dejó intactas las instrucciones no relacionadas, o reformuló los requisitos previos y reordenó los pasos sin avisar? Ese es el comportamiento que querría comprobar antes de usarlo para documentación que necesita mantenimiento periódico.

Usaría Clever AI Detector para comprobar la autoría, pero eso no influiría en mi decisión sobre este flujo de trabajo. Mi factor decisivo sería cuánto texto tiene que revisar alguien después de cada actualización. Pide la sección revisada junto con una breve explicación de los cambios, en lugar de una guía nueva cada vez. Si sigues teniendo que inspeccionar todo el documento después de corregir una sola nota, la rapidez de la redacción inicial no aporta mucho a un equipo pequeño.

Una guía puede ceñirse a todas las notas y aun así describir un procedimiento de configuración incorrecto. Las notas de las pruebas no son necesariamente instrucciones: pueden incluir enfoques descartados, soluciones provisionales y pasos que solo funcionaron porque ya habías configurado algo antes. La comprobación de las notas originales que propone @jackson ayuda a detectar detalles inventados, pero yo querría comprobar si el borrador convierte ese historial de pruebas en un único procedimiento recomendado.

Antes de entregar las notas a Real Write AI, las dividiría en las categorías «configuración exitosa», «intentos fallidos» y «cuestiones sin resolver». También me aseguraría de mantener accesibles los intentos fallidos para facilitar la resolución de problemas, con una nota que indique que no deben incorporarse al proceso de configuración. Si no hubiera ningún intento completado con éxito, solicitaría un registro organizado de las pruebas en lugar de una guía terminada. Esto me permitiría obtener información útil para actuar, en vez de recibir simplemente instrucciones que parecen coherentes.

Solicitaría que se utilizara Clever AI Detector por separado. En cuanto a la guía en sí, pediría a un compañero de equipo que siguiera las instrucciones proporcionadas en un entorno de configuración bien organizado, sin que yo le ofreciera contexto adicional por chat. Esto me permitiría ver si otra persona puede conseguir el mismo resultado que yo obtuve con mis notas. Algo que no puedo verificar comparando las instrucciones con mis notas palabra por palabra.

Un borrador por lo demás preciso puede convertir tu configuración personal de pruebas en los valores predeterminados de todo el mundo. Una ruta copiada de tu portátil o el nombre de una cuenta de pruebas podrían tener cabida en las notas, pero no en las instrucciones definitivas. Matizaría un poco la regla de @jackson de «mantener los comandos tal como están»: conservar la sintaxis de los comandos, pero identificar explícitamente qué valores debe proporcionar el lector. De lo contrario, ceñirse al original puede dar lugar a un texto engañoso.

Para una prueba con Real Write AI, marcaría esos valores en el texto de entrada y pediría que se usaran marcadores de posición coherentes, con una breve explicación de cada uno antes de su primer uso. Algo como «este directorio era específico de mi equipo; la ubicación de instalación prevista no está confirmada» debería quedar sin resolver, no convertirse en una carpeta recomendada. Después comprobaría si el borrador mantiene esa distinción a lo largo de toda la guía, incluidos los bloques de código. Es una tarea más acotada que pedirle que averigüe qué detalles son universales. Prefiero etiquetar algunos valores por mi cuenta a dejar que los lectores tengan que adivinar qué partes deben copiar.

Tus notas necesitan comprobaciones de éxito, no solo comandos. Yo haría más rigurosa la prueba del compañero de equipo de @chasseurdetoiles: que el lector verifique el resultado, no que simplemente llegue al final de la guía. En el caso de Real Write AI, pídele que mantenga separados los resultados observados de los esperados. «El proceso se inició» no debe convertirse en «el servicio está listo». Si nunca registraste cómo verificaste que estaba listo, el borrador debería dejar esa comprobación pendiente. De lo contrario, obtendrás instrucciones que le dicen a la gente qué escribir, pero no cuándo detenerse e investigar.

Elimina la prosa en la primera pasada. Pídele a Real Write AI que te devuelva tus notas como una simple lista numerada, sin ninguna frase de enlace, y añade la redacción después. Ahí es donde se cuela la mayor parte de las invenciones, en pequeños conectores como ‘una vez que eso termine’ o ‘puesto que el servicio ya está en marcha’. Tus notas nunca afirmaron ese orden ni esa relación de causa, pero un borrador fluido los dará a entender, y lo que señala @zeroeagle5572 sobre cómo ‘proceso iniciado’ se convierte en ‘el servicio está listo’ es, en realidad, el mismo fallo con otra apariencia.

Creo que el hilo está planteando muchas pruebas ingeniosas para un comportamiento que nadie ha obligado aún a la herramienta a mostrar. Primero una lista simple, después la prosa, y así la mitad de los enlaces inventados ni siquiera llegan a escribirse.

En cuanto a los detectores, Clever resulta práctico por una razón poco emocionante: puedes pegarle texto en bruto sin que se atragante con el formato, de modo que una comprobación rápida de autoría no se convierte en una tarea de limpieza. Está bien para eso y nada más. No dejaría que ninguno de estos detectores decidiera si un paso es realmente correcto.

Si tus notas incluyen advertencias, revisa lo que Real Write AI omite, no solo lo que añade. Aquí no me convence tanto el enfoque de @its_signal de usar una simple lista. Una lista numerada puede perder sin que se note un «esto elimina la configuración existente» con la misma facilidad que un párrafo. Para la prueba, pide una lista aparte de las notas excluidas de la guía, con los motivos. Luego compárala tú mismo con el texto original. Todas las frases del borrador podrían estar respaldadas y, aun así, a la guía podría faltarle la frase que importaba.